ÉTUDE DE CAS 04 / PARCOURS MACHINE LEARNING
AI/ML Toolbox.
Un espace de travail pour préparer les jeux de données, les explorer, entraîner des modèles, évaluer les résultats et effectuer des prédictions.
Machine learning & développement applicatif
Dépôt public · Projet personnel
Le problème
Les expérimentations en machine learning répètent souvent les mêmes étapes : nettoyer les données, comprendre les variables, choisir un modèle, l’évaluer et le réutiliser. Des scripts dispersés rendent ce parcours plus difficile à suivre.
Contexte & rôle
J’ai créé une bibliothèque Python et une interface applicative pour organiser ce parcours. Le projet associe des modules réutilisables à un ensemble plus ciblé de fonctionnalités interactives.
La solution
Le parcours couvre la préparation des données, l’analyse exploratoire, la sélection de variables, l’entraînement, l’évaluation et la prédiction. Les modèles enregistrés peuvent être réutilisés sur de nouvelles données.
La bibliothèque sous-jacente contient 53 modules. L’application n’en expose qu’un sous-ensemble : ce nombre ne désigne pas 53 choix de modèles disponibles dans l’interface.
Choix techniques
Utiliser l’écosystème Python pour relier préparation et analyse aux bibliothèques de machine learning, notamment scikit-learn et TensorFlow.
Séparer la bibliothèque réutilisable de l’application permet de développer des expérimentations et des outils avant de les intégrer à un parcours pris en charge par l’interface.
Éléments présentés
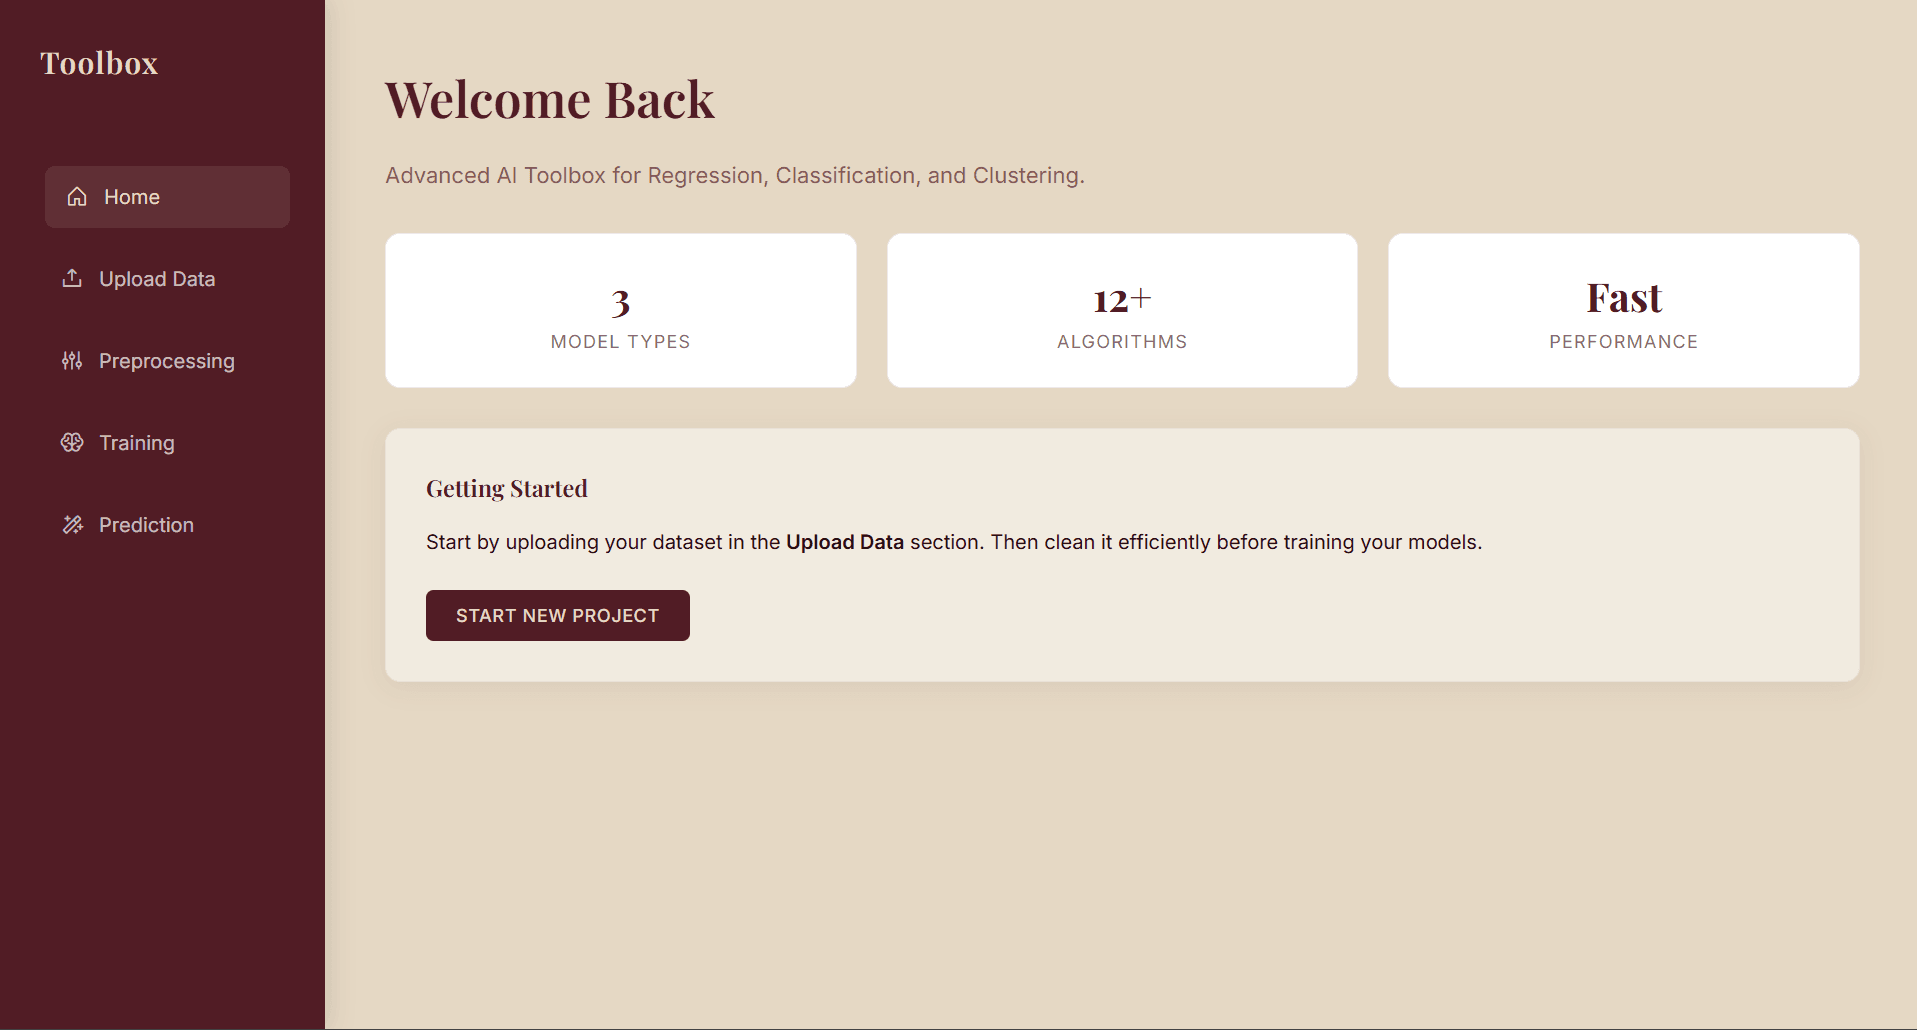
Le visuel est une capture existante de l’application issue du dépôt public. Le dépôt rassemble les modules de la bibliothèque et l’implémentation de l’application.
Le projet montre un parcours d’expérimentation structuré. Il ne prétend pas fournir un meilleur modèle universel ni un résultat de référence commun à des jeux de données différents.
Limites
L’évaluation dépend du jeu de données, de la cible, de la stratégie de séparation et de la métrique. Un bon résultat sur une expérience ne garantit pas les performances sur de nouvelles données.
Tous les modules ne sont pas disponibles dans l’application. La qualité des données, les risques de fuite d’information et le choix de la validation demandent toujours une analyse humaine.
Explorer le projet
Le lien vers le code ouvre AI-ML-toolbox, où l’application et les modules sous-jacents peuvent être examinés ensemble.